Les programmes de maintenance prédictive IoT échouent sans cette couche manquante
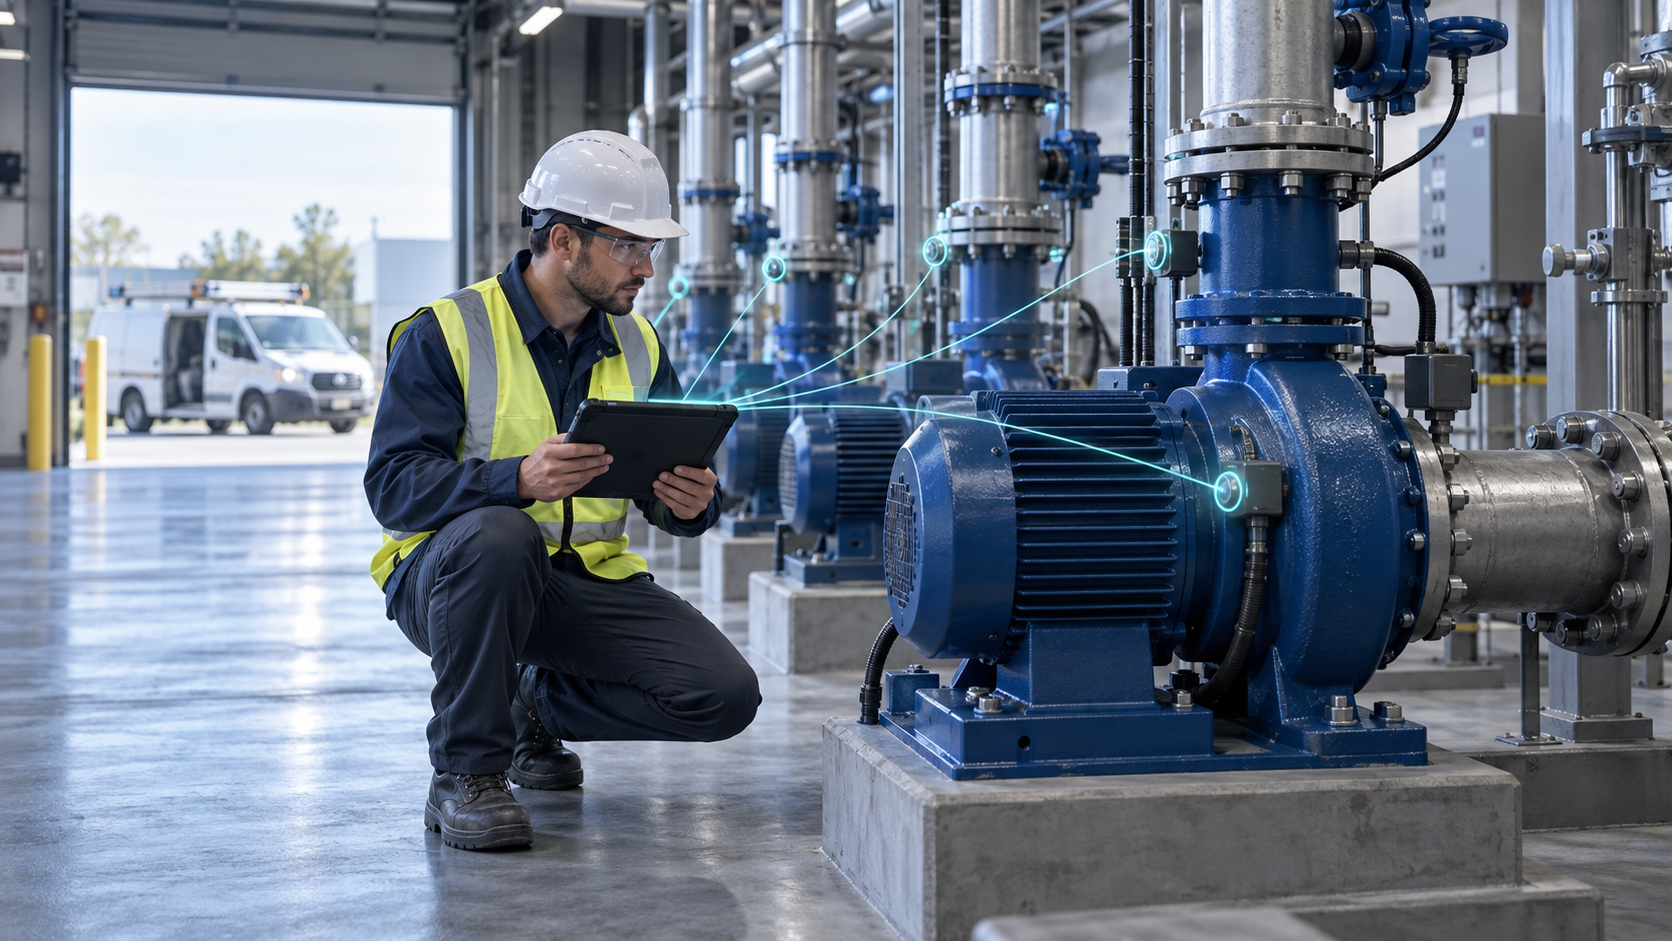
La plupart des programmes de maintenance prédictive IoT investissent massivement dans les capteurs et les modèles, puis s'enlisent parce que seule l'équipe data peut poser une question au parc. Combler cet écart, et non ajouter davantage de capteurs, est ce qui réduit réellement les déplacements et les coûts d'intervention.
« Nous avons les données. Nous ne pouvons simplement rien leur demander. »
C'est la phrase qu'un directeur exploitation et maintenance nous a dite après dix-huit mois et un déploiement de maintenance prédictive IoT à six chiffres.
Les capteurs étaient installés. L'historien était rempli. Le modèle était entraîné. Et les déplacements n'avaient pas bougé.
Non pas parce que les capteurs fonctionnaient mal. Parce que personne en dehors de l'équipe data ne pouvait poser une question au parc et obtenir une réponse à temps pour agir.
Les capteurs n'ont jamais été le goulot d'étranglement
La plupart des contenus sur la maintenance prédictive IoT, y compris les explications d'AWS et d'AspenTech qui dominent les résultats de recherche, décrivent la même chaîne : les capteurs collectent les données, le logiciel les analyse, les modèles prédisent la panne avant qu'elle n'arrive. Cette chaîne fonctionne. Les travaux sur la maintenance prédictive basée sur l'IoT pour les machines industrielles, comme l'étude de classification AdaBoost publiée dans Alexandria Engineering Journal, montrent que les techniques d'apprentissage automatique sous-jacentes sont mûres.
Ce que ces contenus passent sous silence : les capteurs et les modèles ne réduisent pas les déplacements à eux seuls. Quelqu'un doit transformer une mesure en décision. Et dans la plupart des organisations, ce quelqu'un est l'équipe data, les deux ou trois personnes qui connaissent le schéma, l'historien et le langage de requête assez bien pour répondre à « pourquoi cet équipement s'est-il mis à l'arrêt ».
Toutes les autres questions attendent dans une file derrière elles.
La boucle qui ne se referme jamais
Voici la boucle opérationnelle que nous observons dans presque toutes les entreprises industrielles qui font de la maintenance prédictive IoT avant Spocky :
- Une anomalie apparaît. Une pression dérive, une température grimpe, une signature vibratoire change. Elle est là, dans les données brutes en séries temporelles.
- Quelqu'un le remarque, un jour. Peut-être qu'une alerte se déclenche. Le plus souvent, c'est un locataire, un client ou un technicien sur le terrain qui le remarque en premier.
- L'exploitation pose une question à l'équipe data. « Pourquoi la pompe B7 s'est-elle arrêtée mardi dernier ? » Ou : « Est-ce que cela est arrivé sur d'autres unités du parc ? »
- L'équipe data met la demande en file d'attente. Elle traite déjà dix autres questions ponctuelles. Celle-ci attend.
- La réponse arrive des jours plus tard, recoupée à la main entre un historien, un journal de maintenance et le souvenir d'un incident similaire.
- Un camion part quand même, parce que l'exploitation ne pouvait pas attendre la réponse, et que partir à l'aveugle devient la norme quand interroger les données ne l'est pas.
Cette boucle se répète pour chaque parc, chaque site, chaque équipe. Nous avons écrit sur ce qui se passe quand une simple question d'arrêt de pompe se transforme en enquête de 11 jours : la mécanique est la même qu'il s'agisse d'une pompe ou de quatre cents pompes à chaleur.
Pourquoi l'équipe data devient le plafond
Les entreprises industrielles collectent des volumes énormes de données brutes. La plupart restent inexploitées, non pas parce qu'elles n'ont pas de valeur, mais parce que les interroger exige des compétences techniques concentrées chez une poignée de personnes.
Cette contrainte limite le nombre de questions que l'exploitation peut poser, ce qui limite le nombre de problèmes détectés tôt, ce qui limite le nombre de déplacements évités.
Ce n'est pas un problème de données. C'est un problème d'accès. Les données existaient depuis le début. Les personnes qui en avaient besoin ne pouvaient pas les atteindre sans passer par quelqu'un d'autre.
Ce qui comble l'écart : une couche de requête conçue pour les opérateurs, pas pour les analystes
Spocky ne remplace ni l'historien, ni les capteurs, ni l'équipe data. Il se place au-dessus comme une couche d'analyse conversationnelle que les opérateurs, les techniciens et les directeurs exploitation et maintenance peuvent utiliser directement : pas de langage de requête, pas de ticket à l'équipe data, pas d'attente.
Demandez à Spocky « pourquoi la pompe B7 s'est-elle arrêtée mardi dernier » et il raisonne directement sur les données brutes en séries temporelles, recoupe automatiquement les journaux de maintenance et renvoie une réponse déterministe et explicable en quelques secondes. Pas une estimation échantillonnée. Pas une supposition en boîte noire. Une réponse traçable construite à partir des mêmes données brutes que l'historien détient déjà.
C'est la différence entre un programme de maintenance prédictive IoT qui produit des tableaux de bord que personne ne consulte et un programme intégré à la boucle que l'équipe exécute déjà.
Nous expliquons la raison technique pour laquelle la plupart des équipes essaient et échouent en pointant un LLM directement sur l'historien dans pourquoi la ré-ingestion de données en séries temporelles dans un LLM échoue à l'échelle industrielle : les volumes en jeu (des milliards de points bruts par équipement) dépassent très vite les fenêtres de contexte. L'architecture compute-down de Spocky envoie la question aux données au lieu d'expédier les données au modèle.
Des réponses à moins de déplacements
Dès que l'exploitation peut poser ses questions directement, la boucle change de forme :
- La détection arrive plus tôt. Une visibilité sur tout le parc fait remonter une anomalie avant qu'un locataire ou un client ne la découvre en premier.
- L'enquête va plus vite. Ce qui prenait des jours entre trois équipes prend maintenant quelques secondes, avec une réponse déjà recoupée avec l'historique de maintenance.
- Les interventions sont mieux ciblées. Les techniciens partent avec la télémétrie, l'historique, les manuels et les interventions précédentes déjà rassemblés, ou bien la panne est résolue à distance et le camion ne part jamais.
- Les interventions sont validées. Au lieu de supposer qu'un correctif a fonctionné, les équipes peuvent le confirmer avec les données et comparer les performances entre sites et parcs.
Un déploiement sur actifs connectés utilisant ce modèle a constaté une réduction de 75 % des visites sur site. Cela ne vient pas de l'ajout de capteurs. Cela vient du fait de laisser les personnes les plus proches du problème interroger elles-mêmes les données, au moment où elles ont besoin de la réponse, le moment même où la décision d'envoyer un camion est prise.
L'équipe data ne perd pas le contrôle, elle récupère son temps
Il ne s'agit pas d'écarter l'équipe data. Les agents de Spocky sont gouvernés par l'équipe data, affinés avec les Forward Deployed Engineers et les opérateurs qui capturent la logique d'investigation propre à chaque parc. L'équipe data reste propriétaire du schéma, de la gouvernance et de la validation.
Ce qui change, c'est la file d'attente. Les questions de routine, la cinquième version de « pourquoi cet équipement s'est-il mis à l'arrêt », la dixième demande de comparaison entre deux sites, sont traitées directement par la personne qui les pose, dans le format dans lequel elle travaille déjà : le langage courant.
Cela libère l'équipe data pour travailler sur les problèmes plus difficiles au lieu d'être le goulot d'étranglement de chaque question opérationnelle. Si vous évaluez comment une couche en langage naturel se place à côté d'un historien existant plutôt que de le remplacer, voyez Historiens de données industrielles contre agents de requête en langage naturel.
Où commence réellement la maintenance prédictive
La prédiction n'est pas la première étape. C'est la dernière.
Avant qu'un modèle puisse prédire une panne de façon fiable, quelqu'un doit valider quels motifs comptent, quelles interventions ont réellement fonctionné et à quoi ressemble la logique de défaillance locale pour ce parc, cette classe d'équipements, cet environnement d'exploitation. Cette validation passe par l'investigation : explorer l'historique brut, tester des explications, confirmer les résultats.
Les agents de Spocky suivent la même progression : explorer, automatiser, agir sous supervision, documenter, puis prédire. Chaque action importante conserve une étape de décision humaine avant que quoi que ce soit ne touche le parc. Aucun agent n'agit sur une pompe, une pompe à chaleur ou une ligne sans que quelqu'un valide d'abord.
Passer directement à un modèle prédictif sans cette couche d'exploration est une raison fréquente d'enlisement des pilotes de maintenance prédictive IoT : le modèle n'a rien de solide en dessous de lui.
Récapitulatif des métriques
- Enquêtes sur les arrêts de pompe : d'une chaîne d'e-mails inter-équipes de 11 jours à une réponse déterministe en quelques secondes.
- Supervision de parc : une équipe de deux personnes supervisant plus de 400 pompes à chaleur, détectant les problèmes avant les clients.
- Visites sur site : 75 % de déplacements en moins dans un déploiement sur actifs connectés.
- Délai de déploiement : des agents de production personnalisés en service en environ trois semaines.
Rien de tout cela n'est venu de l'installation de capteurs supplémentaires. Cela est venu du fait de donner à l'exploitation un moyen de poser directement une question au parc.
Parlons-en
Si votre investissement en maintenance prédictive IoT génère des données plus vite que votre équipe ne peut leur poser des questions, c'est l'écart qu'il vaut la peine de combler ensuite.
Parlez à notre équipe ou lisez d'autres retours clients pour voir comment la boucle change quand les opérateurs peuvent interroger le parc eux-mêmes.
FAQ
Qu'est-ce que la maintenance prédictive IoT ?
La maintenance prédictive IoT utilise des capteurs installés sur les équipements pour collecter des données en temps réel (température, vibration, pression, vitesse) et les analyse pour détecter les premiers signes de défaillance avant la panne. Les capteurs et les modèles ne représentent que la moitié du système ; l'autre moitié, c'est la capacité réelle de l'exploitation à interroger ces données assez vite pour agir.
Quels sont les trois types de maintenance prédictive ?
Les trois approches courantes sont la surveillance conditionnelle (réagir au franchissement d'un seuil), la prédiction statistique ou basée sur des modèles (utiliser les historiques de défaillance pour estimer la durée de vie utile restante) et la classification par apprentissage automatique (entraîner un modèle à reconnaître les signatures de défaillance dans les données de capteurs, comme dans des applications industrielles telles que la classification des arrêts de machines à tricoter).
Pouvez-vous donner un exemple de maintenance prédictive ?
Un exemple courant est un parc de pompes ou de pompes à chaleur où des capteurs de température et de pression alimentent un historien, et où une anomalie dans la mesure déclenche une enquête pour savoir si l'unité risque de s'arrêter. La valeur apparaît lorsque cette enquête et la décision d'envoyer un technicien qui peut en découler prennent quelques secondes au lieu de plusieurs jours.
Pourquoi davantage de données de capteurs ne réduit-il pas à lui seul les déplacements ?
Les données de capteurs ne réduisent les déplacements que si les personnes qui décident des interventions peuvent les interroger directement. Quand seule l'équipe data peut exécuter cette requête, les demandes s'accumulent, les réponses arrivent tard et les techniciens sont envoyés de façon réactive au lieu de partir avec le bon diagnostic et les bonnes pièces déjà préparées.
Ajouter une couche de requête en langage naturel remplace-t-il l'équipe data ?
Non. L'équipe data continue de gouverner le schéma et de valider la logique. Une couche en langage naturel retire de sa file les questions répétitives et ponctuelles pour que l'exploitation obtienne elle-même les réponses de routine, ce qui libère l'équipe data pour des travaux à plus forte valeur.