Le véritable goulot d’étranglement de la maintenance prédictive IoT industrielle, ce ne sont pas les capteurs, mais les questions que vous n’avez pas encore posées
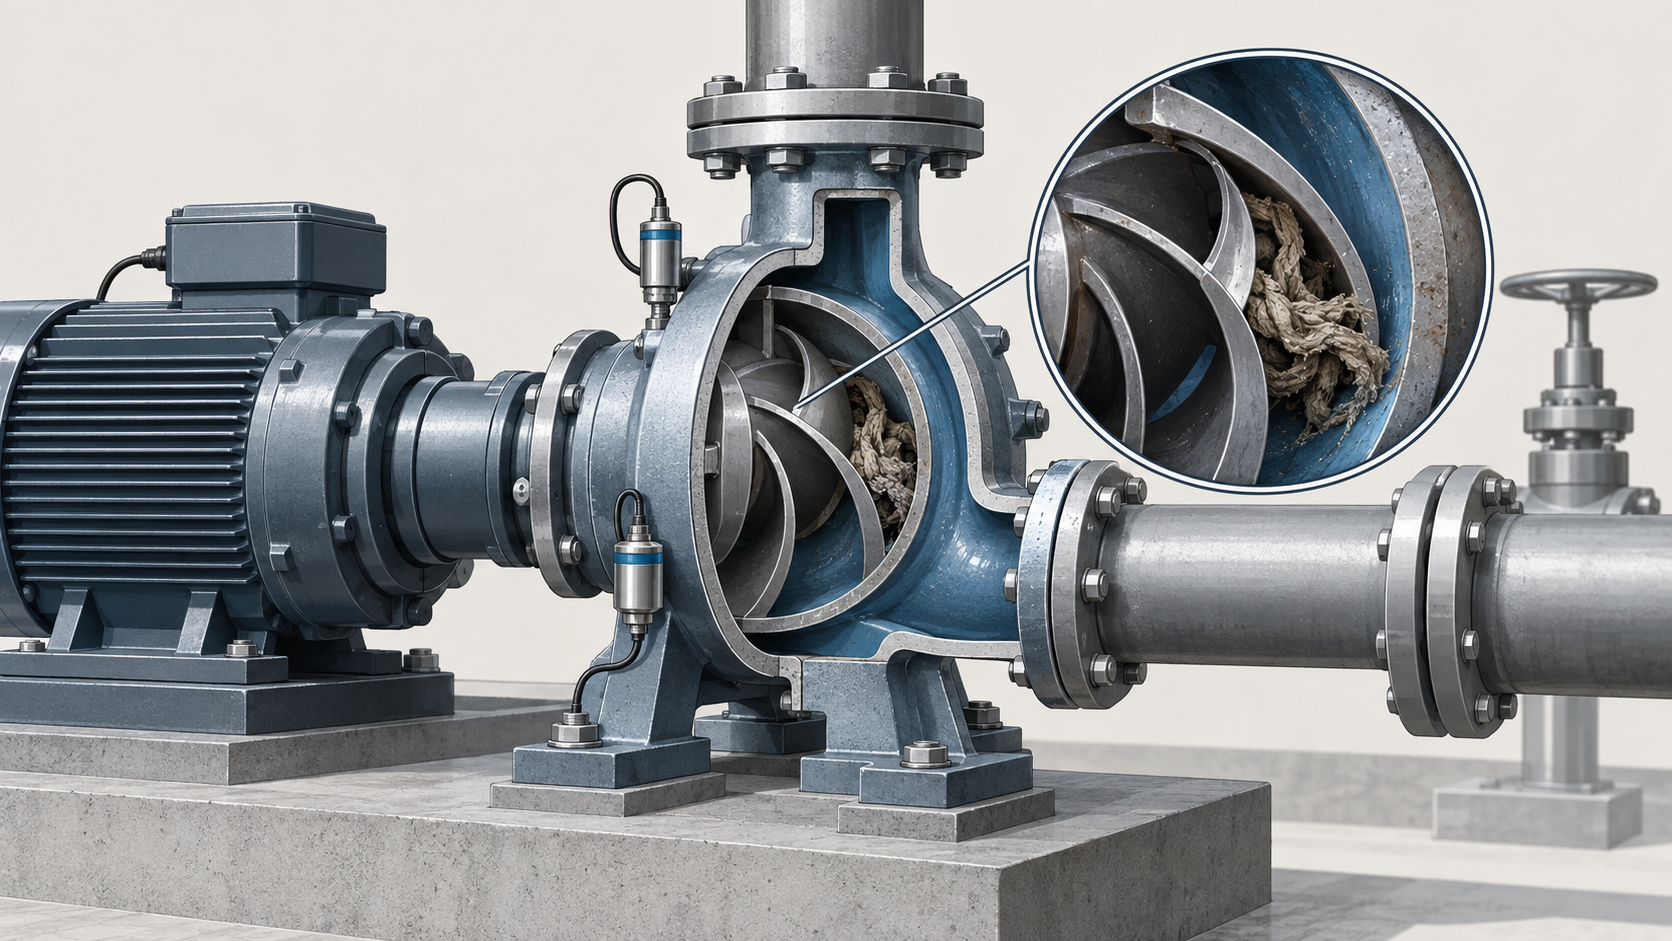
La plupart des programmes de maintenance prédictive IoT industrielle collectent les données et entraînent le modèle, puis s’enlisent dès que quelqu’un pose une question que personne n’avait prévue. La couche manquante n’est pas constituée de capteurs supplémentaires, mais d’un moyen d’enquêter sur les questions au moment où elles sont posées.
« Pourquoi la pompe B7 s’est-elle mise à l’arrêt mardi dernier ? »
Voilà la question. Elle semble simple. Elle ne l’est pas.
Les données des capteurs existent. L’historien de données les contient. La plateforme IIoT les a ingérées en temps réel, horodatées et stockées. Selon tous les critères d’une architecture moderne de maintenance prédictive IoT industrielle, l’infrastructure a fait son travail.
Pourtant, la réponse prend 11 jours. La question passe par l’équipe de maintenance, puis par la qualité, puis par le fournisseur qui a installé la pompe. Quelqu’un extrait un CSV. Quelqu’un d’autre construit un tableau croisé dynamique. Un technicien essaie de se rappeler ce qu’il a vu ce matin-là. Lorsque quelqu’un finit par relier la mise à l’arrêt à une cause, l’usine a effectué une douzaine de cycles supplémentaires et le contexte a disparu.
Ce n’est pas un problème de données. Les données étaient là depuis le début. C’est un problème de questions, et c’est précisément celui que la maintenance prédictive IoT industrielle n’a jamais été conçue pour résoudre.
Le récit standard : collecter les données des capteurs, entraîner un modèle, prédire la défaillance
La plupart des projets de maintenance prédictive IoT industrielle suivent le même scénario :
- Équiper l’actif de capteurs de vibrations, de température ou d’intensité électrique.
- Transmettre les données à un historien de données ou à une plateforme cloud.
- Entraîner un modèle d’apprentissage automatique pour classer ou prédire un mode de défaillance connu.
- Déclencher une alerte lorsque le niveau de confiance du modèle franchit un seuil.
Cela fonctionne pour les modes de défaillance sur lesquels le modèle a été entraîné. Les recherches publiées le confirment : une étude récente a entraîné un modèle AdaBoost à classer six types précis d’arrêts de machines à tricoter et a atteint une précision de 92 % sur le jeu de test (ScienceDirect). C’est un résultat réel, obtenu pour une question définie et anticipée : lequel de ces six types d’arrêts vient de se produire ?
Mais posez au modèle une question à laquelle il n’a pas été entraîné à répondre, pourquoi cette pompe s’est-elle mise à l’arrêt, ce mardi, dans ces conditions, alors que rien de semblable ne s’était jamais produit, et le modèle n’a rien à dire. Il n’a pas été conçu pour cette question. Personne ne la lui avait encore posée.
L’industrie connaît cette lacune depuis des années. Dès 2018, une enquête de Bain and Company largement citée constatait que l’enthousiasme pour la maintenance prédictive fondée sur l’IoT avait en réalité diminué par rapport à deux ans auparavant, en partie parce que l’infrastructure informatique de l’époque n’avait pas la capacité de montée en charge nécessaire à l’acquisition, au traitement et à la modélisation des données qu’exigent les solutions d’analyse prédictive (AWS). L’infrastructure a mûri depuis. Le problème des questions n’a pas disparu.
Vous ne pouvez pas modéliser des questions que vous n’avez pas encore posées
Chaque modèle prédictif encode une question que quelqu’un a anticipée en le construisant. Chaque tableau de bord encode les questions que quelqu’un a pensé à poser en le concevant. Cela convient jusqu’au moment où les opérations font surgir une question que personne n’avait anticipée, ce qui arrive constamment, car les opérations sont le domaine de l’inattendu.
« Pourquoi la pompe B7 s’est-elle mise à l’arrêt » ne figure dans aucun tableau de bord. Pas plus que « cette signature vibratoire s’est-elle déjà produite sur une autre pompe du parc » ou « le correctif appliqué par ce technicien a-t-il réellement fonctionné la dernière fois, ou le problème est-il réapparu trois semaines plus tard ». Ce sont précisément les questions qui déterminent les temps d’arrêt, les coûts de main-d’œuvre et le rendement, et précisément celles auxquelles un modèle entraîné sur des modes de défaillance connus ne peut pas répondre.
Les programmes de données qui sous-tendent la plupart des architectures de maintenance prédictive IIoT sont conçus pour préparer l’information à des cas d’usage anticipés. Les opérations ne respectent pas ce plan. Elles continuent de produire de nouvelles questions. Dans l’architecture standard, chacune devient un nouveau projet data : définir la requête, extraire les tables, écrire le script, attendre l’équipe data.
C’est cette file d’attente qui se cache derrière la chaîne d’emails de 11 jours. Découvrez ce qu’une étude de cas de maintenance prédictive IoT omet généralement, à savoir tout ce qui se passe avant même que le modèle ne s’exécute.
Pourquoi réinjecter les données dans un LLM ne résout pas non plus le problème
Le réflexe évident consiste ensuite à diriger un LLM vers les données brutes de séries temporelles et à le laisser répondre aux questions en langage courant. Cela semble être la solution. Cette approche se heurte presque immédiatement à un mur.
Une pompe à chaleur, sur une semaine de télémétrie brute, peut représenter un volume 5 à 30 fois supérieur à la plus grande fenêtre de contexte disponible aujourd’hui sur le marché. Multipliez cela par un parc de centaines d’actifs et des années d’historique : réinjecter des milliards de points bruts dans un LLM à chaque question consomme des tokens, dépasse les limites de contexte et ajoute une latence que l’opérateur ne peut pas se permettre.
Il s’agit d’une incompatibilité structurelle, et non d’un problème de montée en charge. Injecter des séries temporelles brutes dans un modèle de langage généraliste revient à traiter un problème mathématique comme un problème de langage. Consultez pourquoi injecter des données brutes de séries temporelles dans un LLM ne fonctionne pas pour comprendre les mécanismes sous-jacents, et pourquoi réinjecter des données de séries temporelles dans un LLM échoue à l’échelle industrielle pour voir ce qui se passe une fois le stade du projet pilote dépassé.
Envoyez le calcul vers les données, pas les données vers le calcul
L’architecture de Spocky inverse le flux. Au lieu d’expédier des milliards de points bruts dans une fenêtre de contexte, elle envoie le calcul là où les données se trouvent déjà : une approche compute-down qui transforme les données de séries temporelles au moment de la requête, au niveau de la source, au lieu de les préagréger dans un ensemble figé de vues anticipées.
Ce choix de conception est ce qui permet à un opérateur de commencer par la véritable question opérationnelle, « pourquoi la pompe B7 s’est-elle mise à l’arrêt », plutôt que par la question à laquelle un tableau de bord a été conçu pour répondre six mois plus tôt. Puisque la transformation s’effectue au moment de la requête, une nouvelle question n’exige pas un nouveau projet data. Il suffit de la poser.
Le résultat : une réponse déterministe et explicable, automatiquement recoupée avec les journaux de maintenance, en quelques secondes au lieu d’une chaîne de 11 jours d’emails et de messages Slack entre trois équipes. Pas une probabilité. Pas une estimation. Une réponse traçable construite sur une représentation pivot stable, qui permet la transformation au moment de la requête quels que soient les modèles de données utilisés par les systèmes sources.
Pour en savoir plus, lisez pourquoi l’enquête sur la mise à l’arrêt de votre pompe prend 11 jours, et comment la réduire à quelques secondes.
L’exploration précède la prédiction, et non l’inverse
Le récit standard présente l’exploration et la prédiction comme une suite linéaire : collecter les données, les explorer une fois, puis construire le modèle et passer à autre chose. Dans la pratique, les projets pilotes de maintenance prédictive s’enlisent précisément parce que cette première étape d’exploration est ignorée ou précipitée. Personne n’a validé quels motifs précèdent réellement la défaillance, quelles interventions les résolvent réellement et quelles particularités locales de cet actif précis comptent.
Un modèle entraîné sur des hypothèses non validées concernant la logique de défaillance semblera sûr de lui tout en ayant tort. Les agents de Spocky sont conçus pour procéder dans l’autre sens : commencer par l’exploration, laisser l’opérateur enquêter et valider les motifs, transformer les motifs validés en alertes et en workflows sous supervision humaine, puis seulement accumuler l’historique opérationnel qui rend une prédiction digne de confiance.
Cette boucle, explorer, automatiser, agir, documenter, prédire, est la même que celle que l’atelier exécute déjà. Spocky s’y intègre au lieu de demander à l’équipe de consulter un nouveau tableau de bord. Pour en savoir plus sur l’écart entre repérer une anomalie et la comprendre, consultez la supervision vous dit ce qui s’est passé, voici ce qu’il faut pour comprendre pourquoi et, sur les raisons pour lesquelles les projets pilotes s’enlisent avant même d’atteindre la prédiction, pourquoi les projets pilotes de maintenance prédictive s’enlisent avant même d’atteindre la prédiction.
Ce que cela signifie pour l’équipe data
Environ 95 % des données industrielles brutes restent inexploitées parce que seule l’équipe data sait comment les interroger. Chaque nouvelle question opérationnelle, même raisonnable et évidente, arrive dans la file d’attente de cette équipe et entre en concurrence avec tout ce qu’on lui demande déjà de construire.
L’analyse en langage naturel ne remplace pas le jugement de l’équipe data. Elle supprime le goulot d’étranglement créé par le fait qu’elle est la seule à pouvoir interroger les données. Les opérateurs et les ingénieurs accèdent directement à l’historique brut par l’intermédiaire d’une couche conversationnelle gouvernée. L’équipe data passe moins de temps à traiter des demandes ponctuelles et davantage à affiner les agents qui y répondent, en gouvernant les données qui les alimentent, en validant ce qui en ressort et en décidant quelles découvertes méritent de devenir une alerte ou un rapport permanent.
C’est une relation différente entre l’infrastructure et son utilisation. L’historien de données, le lakehouse ou la plateforme IIoT reste le système de référence. Spocky devient la couche qui le rend utilisable par tous ceux qui ont une question, et pas seulement par ceux qui connaissent le langage de requête. Pour examiner cette distinction de plus près, consultez historiens de données industrielles contre agents de requête en langage naturel : ce qui change sur le terrain.
Maintenance prédictive contre maintenance préventive, et pourquoi le modèle seul n’a jamais été la ligne d’arrivée
Une partie de la confusion autour de la maintenance prédictive IoT industrielle vient du fait que le terme « prédictive » est présenté comme une unique ligne d’arrivée : installer des capteurs, entraîner un modèle, terminé. En réalité, la maintenance prédictive se situe en aval d’une chaîne de décisions : quoi surveiller, comment enquêter sur une anomalie, quelles interventions valider et comment transformer un motif validé en quelque chose de durable.
Ignorez l’étape d’enquête et la prédiction repose sur des fondations instables. Pour comprendre plus précisément la différence entre réagir à un calendrier et réagir à des éléments probants, consultez maintenance prédictive contre maintenance préventive : pourquoi la différence compte plus que le mot à la mode.
À retenir
La maintenance prédictive IoT industrielle n’échoue pas parce que les capteurs manquent ou que le modèle est mal entraîné. Elle échoue parce que l’architecture suppose que chaque question digne d’être posée a déjà été anticipée.
Les opérations ne fonctionnent pas ainsi. Elles produisent un « pourquoi la pompe B7 s’est-elle mise à l’arrêt mardi dernier » un mercredi quelconque, sans aucun tableau de bord conçu pour y répondre. La solution n’est pas d’ajouter davantage d’instrumentation. C’est une couche capable de prendre une question brute et imprévue, de transformer les données de séries temporelles pertinentes au moment de la requête et de restituer une réponse déterministe et explicable, assez rapidement pour compter et assez traçable pour inspirer confiance.
Parlez à notre équipe, ou lisez d’autres retours clients, pour voir ce que cela donne sur votre propre parc.
FAQ
Pourquoi les modèles de maintenance prédictive IoT industrielle échouent-ils face à de nouveaux problèmes ?
La plupart des modèles sont entraînés à reconnaître des modes de défaillance précis et anticipés. Lorsqu’un opérateur pose une question sur un événement inédit, une mise à l’arrêt isolée ou une combinaison inhabituelle de conditions, le modèle ne dispose d’aucune réponse apprise, car personne n’a défini cette question lors de sa construction.
Puis-je simplement diriger un LLM vers mes données brutes de capteurs pour obtenir des réponses de maintenance prédictive ?
Pas directement à l’échelle industrielle. La télémétrie d’une pompe à chaleur sur une seule semaine peut représenter un volume 5 à 30 fois supérieur à la plus grande fenêtre de contexte disponible aujourd’hui. Réinjecter des milliards de points bruts à chaque question consomme des tokens et ajoute de la latence au lieu d’accélérer la réponse.
En quoi Spocky diffère-t-il d’une plateforme standard de maintenance prédictive IIoT ?
Spocky ajoute une couche d’enquête au-dessus des historiens de données et de l’infrastructure IIoT existants. Au lieu de construire à l’avance des tableaux de bord pour des questions anticipées, il transforme les données brutes de séries temporelles au moment de la requête afin que les opérateurs puissent poser une nouvelle question et obtenir une réponse déterministe et explicable sans lancer un nouveau projet data.
L’analyse en langage naturel supprime-t-elle le besoin d’une équipe data ?
Non. Elle évite que l’équipe data soit la seule à pouvoir interroger les données. L’équipe data continue de gouverner les données et d’affiner les agents ; les opérateurs bénéficient d’un accès direct et en libre-service pour les questions récurrentes et ponctuelles qui s’accumulaient auparavant dans la file d’attente de l’équipe data.
Spocky permet-il à un agent d’agir sur un équipement sans l’approbation d’une personne ?
Non. Le modèle de déploiement standard de Spocky maintient une étape de décision humaine avant toute action supervisée sur un parc. L’agent présente les éléments probants et la recommandation ; une personne donne son accord.