Requêtes de séries temporelles sans latence : pourquoi les opérateurs ne peuvent pas inspecter des données en cache
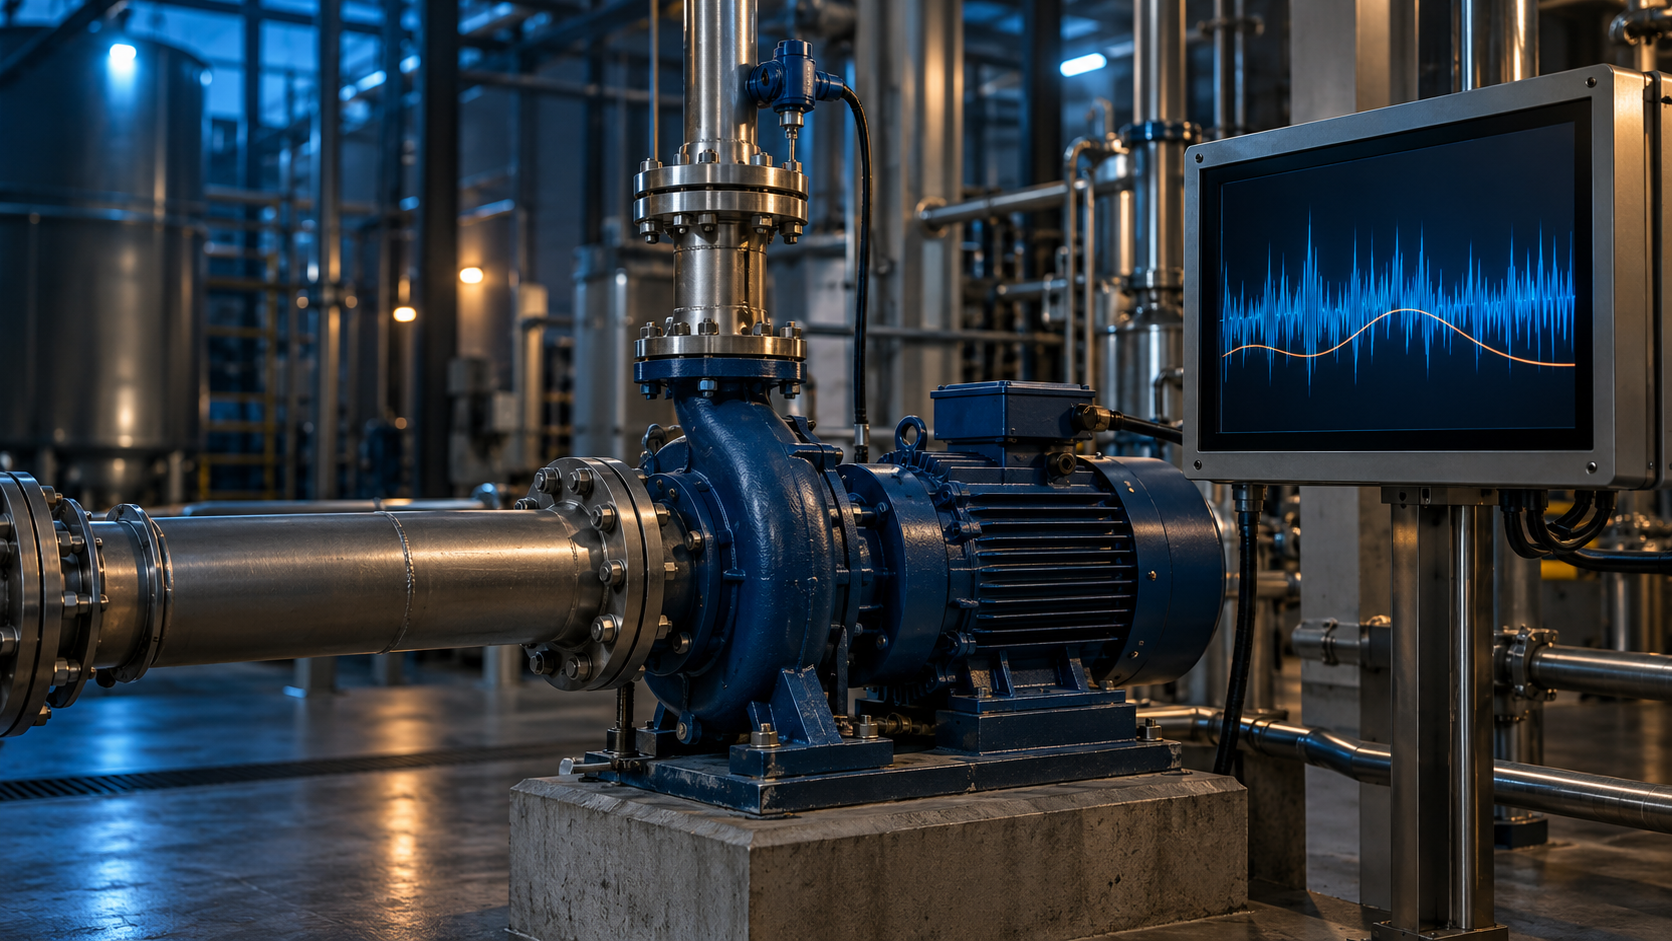
« Le tableau de bord dit que tout va bien. La machine dit le contraire. » Les opérateurs ne peuvent pas mener d'inspections avancées sur des données déjà moyennées, échantillonnées ou mises en cache avant de leur parvenir. Ils ont besoin d'une interrogation à faible latence des séries temporelles brutes, intégrée à la boucle qu'ils utilisent déjà.
« Quand je le vois sur le tableau de bord, le signal a déjà été lissé »
C'est ce que nous a dit un opérateur en atelier, devant un écran affichant une courbe parfaitement lisse, moyennée sur cinq minutes, pour une pompe qui s'était déjà arrêtée deux fois pendant son poste.
Le tableau de bord n'avait pas tort. Il n'affichait simplement pas les données brutes. Entre le capteur et l'écran, quelqu'un avait décidé de la résolution accessible à l'opérateur et du délai avant qu'il puisse la consulter.
Cette décision, prise dans un traitement par lots, une table d'agrégats ou une couche de pré-agrégation, est l'endroit où la plupart des inspections avancées meurent discrètement avant même de commencer.
Deux façons de présenter les données à un opérateur
Il n'existe en réalité que deux voies architecturales pour fournir des séries temporelles à une personne qui se tient devant une machine.
Première voie : agréger d'abord, interroger ensuite. Les points bruts sont résumés sous forme d'agrégats, de moyennes ou de vues sous-échantillonnées au moment de l'ingestion. Le tableau de bord est rapide parce que le travail complexe a déjà été effectué en amont, avant même qu'une question soit posée. C'est efficace pour un graphique. C'est une impasse pour une inspection, car la résolution nécessaire pour détecter un pic transitoire, une courte oscillation ou une anomalie de cinq secondes a déjà été supprimée.
Deuxième voie : le compute-down. Les données brutes restent brutes. Le calcul, la corrélation, le filtre ou la comparaison avec mardi dernier s'exécute au moment de la requête, sur l'historique en pleine résolution, et la réponse revient en quelques secondes. Rien n'est éliminé avant que l'opérateur ne pose sa question, puisque personne ne connaissait cette question à l'avance.
Spocky repose sur la deuxième voie. Nous avons détaillé ce compromis dans notre cadre d'analyse compute-down face à l'ingestion préalable, mais l'idée essentielle est simple : agréger revient à parier sur les questions qui compteront. Les opérateurs posent celles sur lesquelles personne n'avait parié.
Pourquoi l'agrégation compromet spécifiquement l'inspection avancée
La supervision et l'inspection ne sont pas le même travail et n'ont pas les mêmes besoins en données.
La supervision demande : cette valeur se trouve-t-elle dans une plage connue ? Une moyenne sur cinq minutes suffit souvent pour y répondre.
L'inspection demande : pourquoi cela s'est-il produit, est-ce déjà arrivé et qu'est-ce qui a changé ? Il faut alors le signal brut, en pleine résolution, horodaté et interrogeable sur plusieurs semaines ou plusieurs années, car la cause se cache souvent dans la partie du signal qu'un agrégat a effacée. Nous détaillons cette distinction dans La supervision vous dit ce qui s'est passé. Voici ce qu'il faut pour découvrir pourquoi.
Un opérateur qui mène une inspection avancée doit pouvoir :
- Extraire le signal brut autour de l'évènement, pas sa moyenne.
- Le comparer aux signaux bruts d'évènements similaires survenus plusieurs semaines ou plusieurs mois auparavant.
- Le recouper avec les journaux de maintenance, les ordres de travail et les notes qualité.
- Obtenir une réponse assez vite pour agir avant le démarrage du cycle suivant.
Un tableau de bord mis en cache et pré-agrégé ne peut enchaîner aucune de ces quatre étapes. Chacune exige de revenir aux données brutes. Si celles-ci ne sont pas interrogeables à faible latence, chaque étape devient un ticket adressé à l'équipe data au lieu de rester dans la boucle de l'opérateur.
Le coût d'un mauvais acheminement des données brutes
L'objection paraît évidente : si la fidélité des données brutes compte autant, pourquoi ne pas envoyer tous les points bruts là où la question reçoit sa réponse ?
Parce que le volume fait s'effondrer cette approche. Les séries temporelles brutes d'une seule pompe à chaleur sur une semaine peuvent représenter 5 à 30 fois la plus grande fenêtre de contexte disponible aujourd'hui, pour un seul actif et une seule semaine. À l'échelle d'un parc, réinjecter l'historique brut dans un modèle à chaque question n'est pas seulement lent, c'est structurellement impossible. Nous approfondissons ce sujet dans Pourquoi réinjecter des séries temporelles dans un LLM échoue à l'échelle industrielle.
Le compute-down résout le problème autrement. Au lieu de déplacer des milliards de points vers la question, il envoie le calcul vers les données, ce qui réduit jusqu'à 90 % la latence et l'utilisation de tokens. L'opérateur obtient toujours une réponse fidèle aux données brutes. Le système n'a simplement jamais besoin de déplacer toute la botte de foin pour trouver l'aiguille.
À quoi cela ressemble dans la boucle de l'opérateur
Un opérateur ne veut pas d'un nouvel outil à consulter. Il veut que celui qu'il utilise déjà réponde plus vite.
Voici la boucle lorsqu'elle bénéficie d'un accès à faible latence aux séries temporelles brutes :
- Détecter. Un agent de contrôle logique signale une anomalie dès son apparition dans le flux brut, au lieu de la laisser enfouie jusqu'à ce que quelqu'un consulte ce graphique par hasard.
- Demander. L'opérateur demande en langage naturel pourquoi l'anomalie s'est produite, sans langage de requête ni ticket à l'équipe data.
- Répondre. Spocky fournit en quelques secondes une réponse déterministe et explicable, recoupée avec les journaux de maintenance et les évènements précédents, parce qu'il interroge directement l'historique brut plutôt qu'un résumé mis en cache.
- Agir. L'opérateur ou le responsable d'atelier prend la décision. Spocky présente les éléments probants, puis une personne valide l'action.
- Documenter. Le constat rejoint l'historique, afin que l'enquête suivante commence avec une longueur d'avance.
C'est la même boucle que nous décrivons dans Pourquoi l'enquête sur l'arrêt de votre pompe prend 11 jours, et comment la ramener à quelques secondes : une question qui mobilisait auparavant trois équipes pendant 11 jours reçoit une réponse en quelques secondes, car personne n'attend qu'une autre personne réagrège d'abord les données.
La fidélité aux données brutes est précisément l'objectif
L'agrégation n'est pas un défaut. C'est le bon choix pour un tableau de bord de direction qui suit la disponibilité sur un trimestre. C'est le mauvais choix pour un opérateur placé à côté d'une machine qui vient d'avoir un comportement inattendu.
La question de l'opérateur n'avait pas été anticipée par la personne qui a construit l'agrégat. Un cache ne peut pas y répondre. Il faut le signal brut, interrogé directement, avec une latence suffisamment faible pour s'inscrire dans le poste de travail en cours.
Voilà le niveau attendu : non pas un tableau de bord plus rapide, mais des données brutes interrogées à la demande, assez vite pour faire partie de l'inspection plutôt que d'en produire un compte rendu après coup.
Récapitulatif des indicateurs
- Jusqu'à 90 % de réduction de la latence et de l'utilisation de tokens en calculant sur les données brutes au lieu de les déplacer
- Des réponses en quelques secondes au lieu d'une chaîne d'e-mails de 11 jours entre trois équipes
- Des résultats déterministes et explicables, sans échantillonnage ni approximation
- Une équipe de deux personnes supervisant plus de 400 pompes à chaleur à partir d'une télémétrie brute en pleine résolution
Parlez à notre équipe
Si vos opérateurs inspectent des graphiques mis en cache plutôt que le signal brut, il s'agit d'un problème d'architecture des données, pas d'un problème humain.
Parlez à notre équipe pour découvrir comment l'interrogation compute-down des séries temporelles s'intègre à la boucle que vos opérateurs utilisent déjà, ou consultez d'autres témoignages clients pour la voir en production.
FAQ
Quelle est la différence entre l'interrogation à faible latence des données brutes et un tableau de bord rapide ?
Un tableau de bord est rapide parce que les données ont été agrégées avant même son chargement : moyennes, agrégats ou vues sous-échantillonnées calculés à l'avance. L'interrogation à faible latence des données brutes signifie que les données en pleine résolution restent brutes et que le calcul s'effectue au moment où la question est posée, sur un historique qui n'a pas été résumé au point de perdre son information.
Interroger les données brutes au moment de la requête n'est-il pas plus lent que lire un tableau de bord en cache ?
Pas avec une architecture compute-down. Spocky envoie le calcul vers les données au lieu de commencer par déplacer des milliards de points bruts, ce qui permet de fournir des réponses déterministes et explicables en quelques secondes plutôt qu'en plusieurs minutes.
Pourquoi ne pouvons-nous pas simplement fournir les données brutes des capteurs à un LLM pour ces inspections ?
À cause du volume. Les séries temporelles brutes d'une seule pompe à chaleur sur une semaine peuvent être 5 à 30 fois plus volumineuses que la plus grande fenêtre de contexte du marché. Réinjecter ce volume pour chaque question consomme des tokens et ne passe pas à l'échelle d'un parc. Le calcul doit s'exécuter sur les données là où elles résident, pas dans la fenêtre de contexte d'un modèle.
Cela remplace-t-il le jugement de l'opérateur ?
Non. Spocky présente les éléments bruts et une réponse déterministe, recoupée avec les journaux et l'historique. Une personne prend toujours la décision et la valide avant toute action sur le parc.
Est-ce utile uniquement pour les alertes en temps réel ?
Non. Une alerte vous indique qu'un évènement vient de se produire. Une inspection avancée cherche à comprendre pourquoi, ce qui exige d'interroger l'historique brut sur plusieurs jours, semaines ou années, et pas seulement de comparer la valeur actuelle à un seuil.